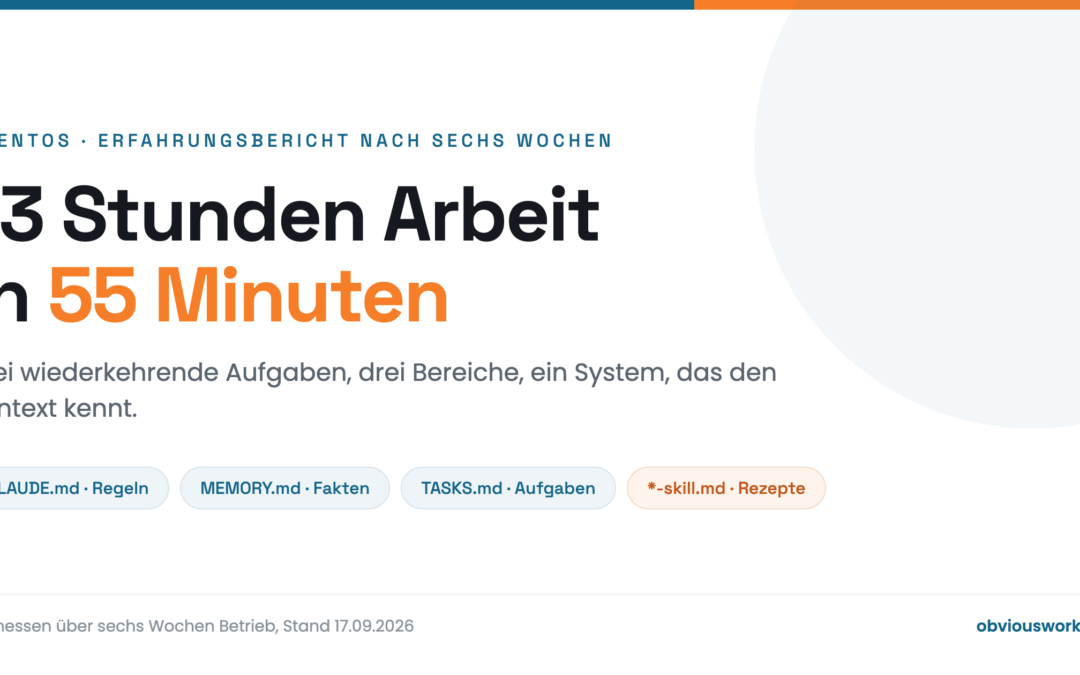
- Drei wiederkehrende Aufgaben aus drei Bereichen brauchten zusammen 13 Stunden. Heute sind es 55 Minuten.
- Ein KI-Betriebssystem löst kein Modellproblem, es löst ein Kontextproblem.
- Das ganze System besteht aus Ordnern und Textdateien: Regeln, Fakten, Aufgaben, Rezepte.
- Betrieben wird es in Claude Code, der Umgebung für Softwareentwickler. Genauso läuft es in Claude Cowork, OpenCode, GitHub Copilot oder OpenAI Codex.
- Das Regelwerk umfasst 4’710 Zeilen. Bei jeder Sitzung geladen werden davon 197.
- Seit September läuft alles auf einem eigenen Rechner, im separaten Netz, mit Zugriff nur in eine Richtung.
- Alles mit Personendaten wird ausschliesslich lokal verarbeitet.
Vor sechs Monaten habe ich hier von 16 Stunden statt 6 Wochen berichtet und behauptet, ich sei mit KI 15-mal schneller gewesen. Das stimmte, und es war trotzdem die schwächere Geschichte. Dieser Bericht hat kleinere Zahlen und härtere. Er handelt davon, was ein KI-Betriebssystem im Alltag wirklich bringt, wo es an Grenzen stösst und wie ich es abgesichert habe.
Warum diese Zahlen belastbarer sind als meine letzten
Es ging damals um Softwareentwicklung. Wer dort ehrlich ist, gibt zu: Die Vorher-Schätzung ist immer weich. Sechs Wochen für ein Projekt, das ich nie von Hand gebaut habe, sind eine Annahme und keine Messung.
Diesmal ist es anders. Es geht um Büroarbeit, die ich seit Jahren jeden Monat selbst mache. Belege verbuchen. Ein Angebot schreiben. Einen Foliensatz bauen. Ich weiss auf die Viertelstunde, was mich das kostet, weil ich es oft genug gemacht habe.
Deshalb halte ich diese Zahlen für die besseren. Sie sind kleiner und sie sind härter.
Warum jeder Chat bei null startet
Die meisten Gespräche über KI drehen sich um Modelle. Welches ist besser, welches ist schneller, welches kann jetzt auch Video.
Mein Alltagsproblem lag woanders. Jeder Chat startete bei null.
- Kontext. Wer ich bin, wie ich schreibe, wie meine Prozesse laufen: jedes Mal neu erklärt.
- Wiederholung. Derselbe Prompt, dreimal pro Monat, jedes Mal leicht anders formuliert.
- Ergebnisqualität. Ohne Kontext produziert auch das beste Modell generische Ergebnisse.
- Vertrauen. Ohne nachvollziehbare Regeln weiss ich nie, was der Agent gerade darf.
Ein KI-Betriebssystem löst kein Modellproblem. Es löst ein Kontextproblem.
Woher die Idee für das KI-Betriebssystem kommt
Ich habe das nicht erfunden, und die Kette dahinter ist kurz genug, um sie ganz zu erzählen.
Das Grundgerüst stammt von Jeff Su, einem Produktivitäts-YouTuber: drei Ebenen, eine Regeldatei, eine Gedächtnisdatei, ein Ordner für Referenzmaterial pro Ebene. Yannik Hauser hat diesen Entwurf aufgegriffen, ihn vom einzelnen Anbieter gelöst und um das erweitert, was aus einer Ablage einen Betrieb macht: Aufgabenlisten, wiederkehrende Routinen und eine geregelte Schicht für gespeicherte Abläufe. Auf seinem Paket läuft mein Setup.
Meine Ergänzung ist der Teil, der in diesem Artikel steht: die Anwendung auf echte Geschäftsprozesse, der Umzug auf eigene Hardware und die Absicherung drumherum.
Claude Code als Harness für Büroarbeit
Im Endeffekt arbeite ich in Claude Code. Das ist eine Umgebung für Softwareentwickler, und genau das war der Bogen, den ich vorher nicht gesehen hatte.
Im AI Developer Bootcamp zeigen wir seit Januar 2025, wie Entwicklungsteams mit genau solchen Umgebungen arbeiten. Die Teilnehmenden bauen dort in Stunden, wofür sie sonst Wochen brauchen: 150 Personen sind inzwischen durch das Format gegangen, im Schnitt waren sie 82 Prozent schneller.
Der Kern dieser Formate ist nie das Modell. Es ist die Harness: die Umgebung, die dem Modell sagt, welche Dateien es kennt, welche Regeln gelten, welche Werkzeuge es aufrufen darf und wo ein Mensch zustimmen muss.
Genau das ist ein KI-Betriebssystem, manchmal auch agentisches Betriebssystem genannt, nur für Büroarbeit statt für Code. Dieselbe Idee, dasselbe Werkzeug, ein anderes Ergebnis. Statt Software zu bauen, baue ich meine eigene Produktivität um.
Das hat mich selbst überrascht. Der Grund liegt in der Sache: Sowohl Entwicklung als auch Büroarbeit bestehen aus wiederkehrenden Abläufen mit definiertem Ergebnis, und beide scheitern an denselben zwei Dingen, nämlich fehlendem Kontext und fehlender Wiederholbarkeit.
Und es hängt an keinem Anbieter. Ich arbeite in Claude Code, aber das Skelett ist älter als meine Werkzeugwahl. Entworfen wurde es für Claude Cowork, die Endnutzer-App, und dort läuft es ohne eine Zeile Terminal. Bei mir liegt es in Claude Code, weil ich die Skills, die geplanten Routinen und die Werkzeug-Anbindung brauche. Optional kommen lokal laufende Modelle dazu.
Der Wechsel wäre in beide Richtungen kein Umbau, weil praktisch jedes dieser Werkzeuge dieselbe Art von Regeldatei liest:
- OpenCode liest seine Regeln aus einer AGENTS.md und fällt auf CLAUDE.md zurück, wenn keine daneben liegt. Es durchsucht dabei auch die übergeordneten Ordner, bringt eigene Skills, MCP-Anbindung und freie Modellwahl mit.
- Der Coding Agent von GitHub Copilot unterstützt AGENTS.md, CLAUDE.md und GEMINI.md gleichzeitig, auch verschachtelt pro Unterordner. Man könnte das Setup also sogar dort betreiben.
- OpenAI Codex erwartet eine AGENTS.md. Dort wird die Datei umbenannt, dann läuft sie.
Ehrlich dazu gehört: Die geplanten Routinen wandern nicht eins zu eins mit, die hängen am jeweiligen Werkzeug. Der Kontext dagegen liegt in meinen Ordnern, und das ist der Teil, der zählt. Es ist der Unterschied zwischen einem Betriebssystem und einem Abo.
Vier Bausteine, klar getrennt
Das ganze System besteht aus Ordnern und Textdateien. Vier Dateitypen tragen es.
Regeln
Was immer gelten soll
- Verhalten und Konventionen
- Routing: welche Anfrage wohin
- Erkennbar an: immer, nie, bevor X mach Y
Fakten
Was wahr ist und sich ändern kann
- Kontakte und Entscheidungen
- Projektstände
- Wird laufend fortgeschrieben
Aufgaben
Was noch offen ist
- Eine Datei pro Bereich
- Die im Wurzelverzeichnis ist der Eingangskorb
- Nie dieselbe Aufgabe an zwei Stellen
Rezepte
Wie ein Ablauf geht
- Feste Sequenz, definierter Output
- Nur bei klarem Auslöser sinnvoll
- Wird ausdrücklich aufgerufen
Diese Trennung ist keine Erfindung von mir, sie gehört zum Bauplan. Verstanden habe ich sie erst im Betrieb. Sobald eine Regel im Rezept steht und zusätzlich in der Regeldatei, driftet eine von beiden auseinander, und danach weiss niemand mehr, welche gilt. Die Regel klingt pedantisch, bis man das einmal erlebt hat.
Workstations statt Agenten-Rollen
Ein verbreiteter Ansatz besteht darin, Agenten wie Mitarbeitende zu modellieren: einen für Recht, einen für Finanzen, einen als Assistenz. Ich habe mich dagegen entschieden und teile stattdessen nach Domänen.
Jeder Bereich bekommt einen Ordner mit demselben Bauplan: Regeln, Gedächtnis, Aufgaben, Referenzmaterial, Rezepte. Eine Anfrage kommt herein, die Routing-Tabelle sagt, welcher Ordner geladen wird. Zehn existieren, einer wird geladen.
Zwei Sorten gibt es. Verteiler, bei denen alles hereinkommt, verarbeitet und weitergereicht wird. Und dedizierte Domänen, in denen Dinge absichtlich landen und liegen bleiben. Der Test dafür ist eine Frage: Ist es ein Durchlauf oder ein Ort, an dem etwas bleibt?
Der Gewinn ist die Vorhersehbarkeit. Wenn jeder Bereich gleich aussieht, muss ich beim Anlegen des elften nichts mehr entscheiden.
Eine Regel musste ich mir dabei selbst auferlegen: Ein Fakt lebt auf genau einer Ebene. Überall sonst steht nur ein Verweis darauf. Beim ersten Mal, als ich ein Detail zwei Ebenen höher zusätzlich notiert habe, liefen die beiden Fassungen innerhalb von zwei Wochen auseinander.
Obsidian als Oberfläche, Git als Historie
Zwei Dinge fehlen in fast allen Erklärstücken zu diesem Thema, und sie machen im Alltag den Unterschied.
Obsidian liegt als Oberfläche über demselben Ordner. Markdown im Texteditor liest sich mühsam, in Obsidian wird daraus ein zusammenhängendes Ganzes: Regeln, Gedächtnis, Aufgaben und Ergebnisse nebeneinander, verlinkt und durchsuchbar. Ich arbeite darin mit dem Agenten zusammen, statt ihm nur zuzuschauen. Wichtig dabei: Obsidian ist eine Ansicht und kein Speicherort. Fällt es weg, bleibt alles, wie es ist.
Git führt die Historie. Das Regelwerk ist versioniert wie Quellcode. Jede neue Regel, jedes neue Rezept, jede Korrektur am Gedächtnis ist ein nachvollziehbarer Stand mit Datum. Ich kann sehen, wann etwas dazugekommen ist, und ich kann zurück.
An dieser Stelle kippt der Vergleich mit den Gedächtnisfunktionen der Anbieter endgültig. Dort sieht man weder, was gespeichert wurde, noch wann es sich geändert hat. Hier lese ich es Zeile für Zeile und lösche, was ich nicht will.
Vier Abläufe, die ich selbst aufrufe
Die Struktur allein reicht nicht. Was sie am Leben hält, sind vier Abläufe.
Auf Zuruf
Was ich aufrufe
Ohne mich
Was von selbst läuft
Eine Routine meldet sich nur bei einem Problem. Alles andere wäre eine weitere Benachrichtigung, die ich wegklicke. Voraussetzung: ein Rechner, der durchläuft.
Ohne diesen Rhythmus verrottet das System. Die Regeln stehen dann zwar noch da, aber niemand pflegt sie nach.
Tone of Voice als eigene Datei
Aus 82 gesendeten Mails habe ich mir meine eigene Schreibstimme extrahieren lassen. Tonalität, Satzbau, Wörter die ich nutze und die ich nie nutze, die Anrede- und Gruss-Leiter nach Formalitätsstufe. Das Ergebnis liegt als eine einzige Datei im System und wird vor jedem Text geladen.
Dazu kommt eine Regel, die ich für den eigentlichen Trick halte. Wenn ich einen Entwurf vor dem Versand umschreibe, ist der Unterschied ein Stil-Signal. Der Agent analysiert ihn und schlägt eine Ergänzung für die Stimmdatei vor. Ändern darf er sie erst nach meiner Freigabe.
So wird das System mit jeder Korrektur besser, ohne dass ich Regeln schreibe. Die Datei wird seit August laufend feingeschliffen, jedes Mal aus einer echten Korrektur heraus.
Angefangen habe ich damit am Flughafen von Bali, auf dem Rückweg. Ein Wartefenster, ein fast verpasster Flug, eine Datei. Alles andere kam danach.
Die Zahlen: 13 Stunden auf 55 Minuten
Drei wiederkehrende Aufgaben aus drei verschiedenen Bereichen, gemessen über sechs Wochen.
Warum die Summe und nicht der beste Einzelwert: Ein einzelnes Projekt lässt sich als Ausnahme abtun. Drei wiederkehrende Aufgaben aus drei Bereichen lassen sich das nicht. Das Einzige, was sie verbindet, ist ein System, das den Kontext kennt.

Der Foliensatz. 18 Folien im Corporate Design, erzeugt aus einem Skript statt in PowerPoint zusammengeschoben. Die 30 Minuten sind keine Rohfassung, das Nachschärfen ist darin enthalten. Bevor ich die Folien später herausgegeben habe, kamen trotzdem noch ein paar Runden dazu. Eine Einschränkung gehört ebenfalls dazu: Es war ein Speaker-Slot, und dafür ist diese Geschwindigkeit angemessen. Für Trainingsunterlagen funktioniert das so noch nicht, dort gehen mehr Vorarbeit und mehrere Review-Runden hinein, und der Qualitätsanspruch ist ein anderer.
Der Monatsabschluss. Der belastbarste Wert der drei, weil ich ihn seit Jahren jeden Monat selbst mache. Die eine Stunde ist dabei der gute Fall: keine Ablenkung, keine unklare Position im Auszug. Mit einer einzigen Ungereimtheit wird deutlich mehr daraus. Im August waren es 29 Ausgangs-Zeilen über drei Währungen, jede gegen einen Beleg geprüft, dazu ein Bericht mit Einzelzeilen, Sonderfällen bei der Mehrwertsteuer und Freigabestatus.
Die Kundenanfrage. Drei Fachdokumente aus einer gemeinsamen Quelle, je als Word und als PDF erzeugt, dazu die Begleitmail. Früher habe ich für so etwas einen halben Arbeitstag gebraucht, vor allem für das Formatieren und das Zusammensuchen von Vorlagen.
| Aufgabe | Vorher | Nachher | Faktor |
|---|---|---|---|
| Foliensatz für einen Speaker-Slot von 45 Minuten | 8 h | 30 min | 16x |
| Monatsabschluss Firmenkreditkarte, drei Währungen | 1 h | 5 min | 12x |
| Antwort auf eine Kundenanfrage | 4 h | 20 min | 12x |
| Zusammen | 13 h | 55 min | 14x |
Tabelle seitlich scrollbar
Wie gross ein KI-Betriebssystem selbst ist
Die Zahl, die mich am meisten überrascht hat, ist die kleinste.
Das gesamte Regelwerk, also alle Regeldateien, alle Gedächtnisdateien, alle Aufgabenlisten und alle Rezepte zusammen, sind 4’710 Zeilen Text. Die Datei, die bei jeder Sitzung geladen wird, ist 197 Zeilen lang.
Das System selbst
4’710
Zeilen Regelwerk
Regeldateien, Gedächtnis, Aufgabenlisten und Rezepte zusammen.
Davon bei jeder Sitzung geladen: 197 Zeilen
Was daraus entstanden ist
326
erzeugte Dateien
221 Markdown-Berichte, Analysen und Entwürfe. Dazu 105 Dokumente in den Ausgabe-Ordnern: Word, PDF, Foliensätze.
Knapp 5’000 Zeilen Regelwerk halten 326 erzeugte Dateien zusammen.
Ein Hinweis zur Ehrlichkeit dieser Zahlen, weil er sonst untergeht: Das Repository ist insgesamt rund ein Gigabyte gross, aber der grösste Teil davon ist Material, das ich hineingegeben habe. Fotos, Kontoauszüge, Belege, Scans. Was der Agent erzeugt, ist reiner Text und braucht fast keinen Platz. Die Menge liegt beim Zugelieferten, der Wert beim Erzeugten.
Der Grund für die Überraschung ist banal und trotzdem wichtig: Die Intelligenz sitzt im Modell, das Regelwerk muss nur den Kontext liefern. Es wächst deshalb nicht mit der Arbeitsmenge, sondern mit der Zahl der Bereiche.
Und es wächst.
Der Umzug auf einen eigenen Rechner
Seit September läuft das Ganze nicht mehr auf meinem Arbeitsgerät, sondern auf einem eigenen Rechner. Das war die grösste Veränderung der letzten Wochen, und der Weg dorthin war unbequemer als gedacht.
Die Beschaffung. Ein guter Mac mini ist weder einfach noch günstig zu bekommen. Wer lokale Modelle betreiben will, braucht Unified Memory und Speicherbandbreite, also einen Pro-Chip. Genau diese Konfigurationen sind im Refurbished-Markt selten, und neu sind sie teuer und momentan nur schwer lieferbar. Die Suche lief über mehrere Schweizer Quellen und hat Wochen gedauert, bis ein passendes Gerät aufgetaucht ist.
Das gehört in einen ehrlichen Erfahrungsbericht, weil es eine Erwartung korrigiert. „Läuft nebenher auf einem kleinen Rechner“ stimmt so nicht, sobald lokale Modelle eine Option bleiben sollen.
Der Betrieb. Der Rechner läuft durchgehend. Ruhezustand deaktiviert, nach einem Stromausfall startet er selbst wieder hoch. Erreichbar ist er von überall über VPN und Bildschirmfreigabe, auch von unterwegs. Dateien tausche ich über eine Dateifreigabe durch denselben Tunnel aus.
Automatisierte Routinen und Checks
Bis hierher ging es um das, was ich in Claude Code selbst aufrufe. Der interessantere Teil ist das, was ohne mich passiert.
Zwei Routinen laufen fest. Der Wochenrückblick über alle Bereiche, freitags nachmittags, samt Struktur-Check gegen den eigenen Bauplan. Und eine tägliche Recherche am Morgen, die sich nur meldet, wenn es etwas Neues gibt.
Im Wochenrückblick steckt seit Kurzem auch der Sicherheits-Check, und zwar jede Woche. Der Grund dafür gehört in einen ehrlichen Bericht: Die Liste der erteilten Berechtigungen wächst im Betrieb von selbst, weil einmalige Freigaben sich eintragen, und neue Anmeldungen tauchen in dieser Liste überhaupt nicht auf. Bei grösseren Abständen stand so etwas wochenlang da, und im Nachhinein liess sich nicht mehr sagen, wozu es erteilt worden war. Eine Woche ist kurz genug, dass sich jede Veränderung noch einem Anlass zuordnen lässt. Ohne Abweichung steht dazu eine einzige Zeile im Bericht.
Dazu kommen Einmal-Prüfungen. Wenn ich wissen will, ob etwas tatsächlich passiert ist, setze ich eine an: ob eine Veröffentlichung auf einer fremden Plattform wirklich online ging und vollständig aussieht, zum Beispiel. Sie läuft zur gesetzten Zeit, prüft nach und meldet sich nur, wenn etwas nicht stimmt.
Eine Routine meldet sich nur bei einem Problem. Alles andere wäre eine weitere Benachrichtigung, die ich wegklicke.
Hier schliesst sich der Kreis zur Hardware. Geplante Aufgaben laufen nur, wenn der Rechner wach ist. Auf einem Arbeitsgerät, das abends zugeklappt wird, ist genau das die Bruchstelle, und deshalb bleibt dieser Teil in vielen Setups eine Baustelle. Ein Gerät, das durchläuft, löst das vollständig.
Was als Nächstes dazukommt, folgt derselben Mechanik:
- Morning Summary. Jeden Morgen der Stand über alle Bereiche: was heute ansteht, was seit gestern dazugekommen ist, woran etwas hängt.
- System Health Check. Sind die Routinen durchgelaufen, ist die Struktur intakt, stimmen die Zugänge mit dem Register überein.
- Mail Triage. Den Posteingang vorsortieren, Entwürfe vorbereiten, den Rest liegen lassen. Versendet wird nichts ohne Freigabe.
Sicherheit: die Trennung und ein Register über jeden Zugang
Über diesen Teil wird in der Diskussion um agentische Setups selten geschrieben. Ich halte ihn für den wichtigsten.
Simon Willison hat das Grundmuster im Juni 2025 unter dem Namen lethal trifecta beschrieben. Drei Fähigkeiten, die einzeln harmlos sind.
Zugang zu privaten Daten
Mails, Kontakte, Rechnungen, Kundendaten. Alles, was der Agent lesen darf.
Lokale Modelle entschärfen den Abfluss, nicht den Zugang
Inhalte von aussen
Webseiten, Dateien, eingehende Mails. Genau hier sitzt die Prompt Injection.
Fremder Text ist Daten, nie Anweisung
Ein Weg nach draussen
Ein einziger Aufruf ins Netz reicht. Eine Mail oder ein Formular erst recht.
Entwurf ja, Versand nur mit Freigabe
Gefährlich wird es, wenn alle drei zusammenkommen. Dann liest ein fremder Text mit, was mir gehört, und schickt es weg. Meine Regel lautet deshalb: Es soll immer eine der drei fehlen.
Was die eigene Hardware dazu beiträgt. Der Rechner hängt in einem separaten WLAN und sieht die übrigen Geräte im Heimnetz nicht. Der Zugriff läuft nur in eine Richtung: Mein Arbeitsgerät kommt auf den Betriebsrechner, nie umgekehrt.
Tragend ist dabei nicht die Netzwerkregel. Tragend ist, dass mein Arbeitsgerät gar keinen Freigabedienst anbietet. Ohne angebotenen Dienst gibt es nichts zu übernehmen.
Daraus folgt ein Detail, das leicht untergeht: Das Backup wird gezogen, nicht geschoben. Ein kompromittierter Rechner soll sein eigenes Backup nicht überschreiben können.
Und der Teil, den ich für den eigentlichen Beitrag halte: ein Register über jeden Zugang. Nicht über die erteilten Werkzeug-Berechtigungen, sondern über die Konten. Fünf angemeldete Konten auf dem Gerät. Drei Fremdsysteme, die am Anmeldekonto der App hängen und bei jedem Umzug unsichtbar mitziehen. Dazu eine Zeile für das, was bewusst nicht angemeldet ist, mit der Begründung.
Jeder neue Login kommt am selben Tag hinein. Entfernte Zugänge werden nicht gelöscht, sondern mit Datum abgeschlossen.
Der Grund dafür in einem Satz: Ein Browser mit aktiver Sitzung ist ein Zugang, auch wenn in keiner Berechtigungsliste etwas davon steht.
Dazu drei Grenzen, die nicht verhandelbar sind. Keine Mail wird automatisch versendet, Entwurf ja, Versand nein. Nichts wird gelöscht ohne meine ausdrückliche Freigabe. Nichts wird gekauft oder gebucht, ohne dass ich zustimme.
Ein Satz zur Einordnung, damit hier nichts besser klingt, als es ist: Ein lokal laufendes Modell entfernt die erste Komponente nicht. Der Agent hat weiterhin Zugriff auf meine Dateien. Was sich ändert, ist der dritte Baustein, denn was lokal verarbeitet wird, verlässt den Rechner nicht.
Genau deshalb trenne ich nach Datenart. Alles, was Personendaten enthält, wird ausschliesslich lokal verarbeitet, also Teilnehmerlisten, Kontaktdaten, Kundenunterlagen. Für alles andere nutze ich die grossen Modelle. Wer Kunden- oder Personendaten in so einem Setup überhaupt verarbeiten will, kommt an dieser Trennung nicht vorbei. Sie kostet Qualität und Geschwindigkeit, und dafür bleiben die Daten, wo sie hingehören.
Was funktioniert und was nicht
Nach sechs Wochen
Was funktioniert
- Klein anfangen. Eine Datei, ein Bereich, ein echter Fall.
- Erst einen Prozess real durchspielen, dann die Regeln daraus schreiben.
- Session Start und Session Audit als feste Klammer um jede Sitzung.
- Rezepte für alles mit klarem Auslöser, Regeln für alles Laufende.
- Eine Oberfläche über denselben Ordner, um den Kontext sichtbar zu machen.
Ebenfalls gelernt
Was nicht funktioniert
- Regeln aus Annahmen vorab schreiben. Die muss man später alle umbauen.
- Dieselbe Information an zwei Stellen pflegen. Eine driftet immer.
- Rezepte für Abläufe ohne klaren Startpunkt. Die bleiben liegen.
- Zu grosse Struktur zu früh. Leere Ordner helfen niemandem.
- Alles automatisieren wollen. Der Freigabeschritt ist kein Umweg.
Der teuerste Fehler war der erste in der zweiten Liste. Spekulative Regeln kosten mehr Zeit als gar keine.
Was das nicht ersetzt
- Die Entscheidung
- Das System legt Optionen auf den Tisch. Bei einer Preisfrage oder einer Scope-Änderung entscheide ich.
- Die Freigabe
- Der Freigabeschritt bleibt auch dann drin, wenn er langsamer ist. Trainingsunterlagen baue ich weiterhin selbst, weil dort mehr dranhängt.
- Die Vorarbeit
- Ohne eigene Vorarbeit skaliert nichts. Die Stimmdatei funktioniert, weil es Jahre an eigenen Mails gibt, aus denen sie extrahiert wurde. Das System vervielfacht, was schon da ist. Wenn nichts da ist, kommt Menge heraus.
Häufige Fragen
Warum Claude Code und nicht einfach ein Chatbot?
Ein Chatbot kennt den Kontext nur so lange, wie das Fenster offen ist. Claude Code liest bei jeder Sitzung Regeln und Gedächtnis aus Dateien, die mir gehören, ruft Werkzeuge auf und arbeitet feste Abläufe ab. Dasselbe Skelett läuft auch in Claude Cowork, wenn man kein Terminal möchte. Entscheidend ist die Umgebung drumherum. Das Modell ist in beiden Fällen dasselbe.
Braucht ein KI-Betriebssystem einen eigenen Rechner?
Für den Anfang nicht. Das Setup lief sechs Wochen auf dem Arbeitsgerät. Sobald Routinen dazukommen, die ohne einen selbst laufen sollen, braucht es ein Gerät, das durchläuft.
Funktioniert ein KI-Betriebssystem mit lokalen Modellen?
Teilweise. Für Zusammenfassungen, Sortierarbeit, Strukturaufgaben und normales Schreiben reicht ein lokal laufendes Modell der mittleren Grössenklasse gut aus. Bei komplexen Aufgaben mit vielen Zwischenschritten fällt die Qualität spürbar ab. Und langsamer ist es in jedem Fall, das ist der Preis.
Was ist mit Finanzdaten?
Da gilt eine harte Grenze: Die Buchhaltung bekommt keinen Zugang. Der Agent bereitet Belege auf, verbucht wird von mir. Jeder weitere Zugang wird einzeln entschieden, nicht pauschal.
Was ist mit Kundendaten?
Die gibt es bei mir laufend, allein schon durch Teilnehmerlisten aus Trainings. Alles, was Personendaten enthält, läuft deshalb über lokal laufende Modelle. Was den Rechner nicht verlässt, kann auch nicht abfliessen.
Lohnt sich der Schritt zu mehreren Agenten?
Im Alltag mache ich das längst, nur nicht als Architektur. Für jede neue Aufgabe startet ein eigener Thread und damit ein eigener Agent, der nur den Kontext dieser Aufgabe lädt. Die Regel dahinter ist simpel: neue Aufgabe, neuer Chat. Eine dauerhafte Agenten-Belegschaft mit festen Rollen brauche ich dafür nicht.
Wie verhindert man Drift zwischen dem Setup und bestehenden Tools?
Über eine klare Zuständigkeit. Kursdetails und Vertriebsdaten liegen in Notion, dort ist die Wahrheit. Das Setup hält Playbooks, keine Kopien.
Wie weit korrigiert sich ein KI-Betriebssystem selbst?
Weiter, als ich erwartet hatte, und nicht von allein. Der Wochenrückblick findet strukturelle Abweichungen und schlägt Korrekturen vor, mechanische behebt er selbst. Alles mit Ermessen legt er mir vor.
Workshop-Format in Entwicklung
Das Interessanteste an sechs Wochen ist nicht die Ersparnis. Es ist, dass die Ersparnis mit jeder Woche grösser wird, weil jede Korrektur zu einer Regel und jeder wiederkehrende Ablauf zu einem Rezept wird.
Wir entwickeln daraus gerade ein Workshop-Format zur Produktivitätssteigerung. Chatbots allein sind fast so outdated wie Code von Hand zu schreiben.
Wer zu den Ersten gehören möchte, die davon erfahren, meldet sich kurz. Ich melde mich, sobald die Termine stehen.
KI hat strukturiert. Gedacht und freigegeben habe ich.
Michael (Mr. Miroboard) Mey
Michael ist ein Trainer, der nicht nur durch sein Wissen, sondern auch durch seine Leidenschaft besticht.
Zu Michaels Trainerprofil
Zu seinem LinkedIn Profil
 DE
 EN